以前のテストで、軽量LLMであるGLM-OCRが座標表の読み取りにある程度使えるめどが立ちました。そこで今回は、CPUや内蔵GPUでどれくらい動かせるのかをテストしてみました。
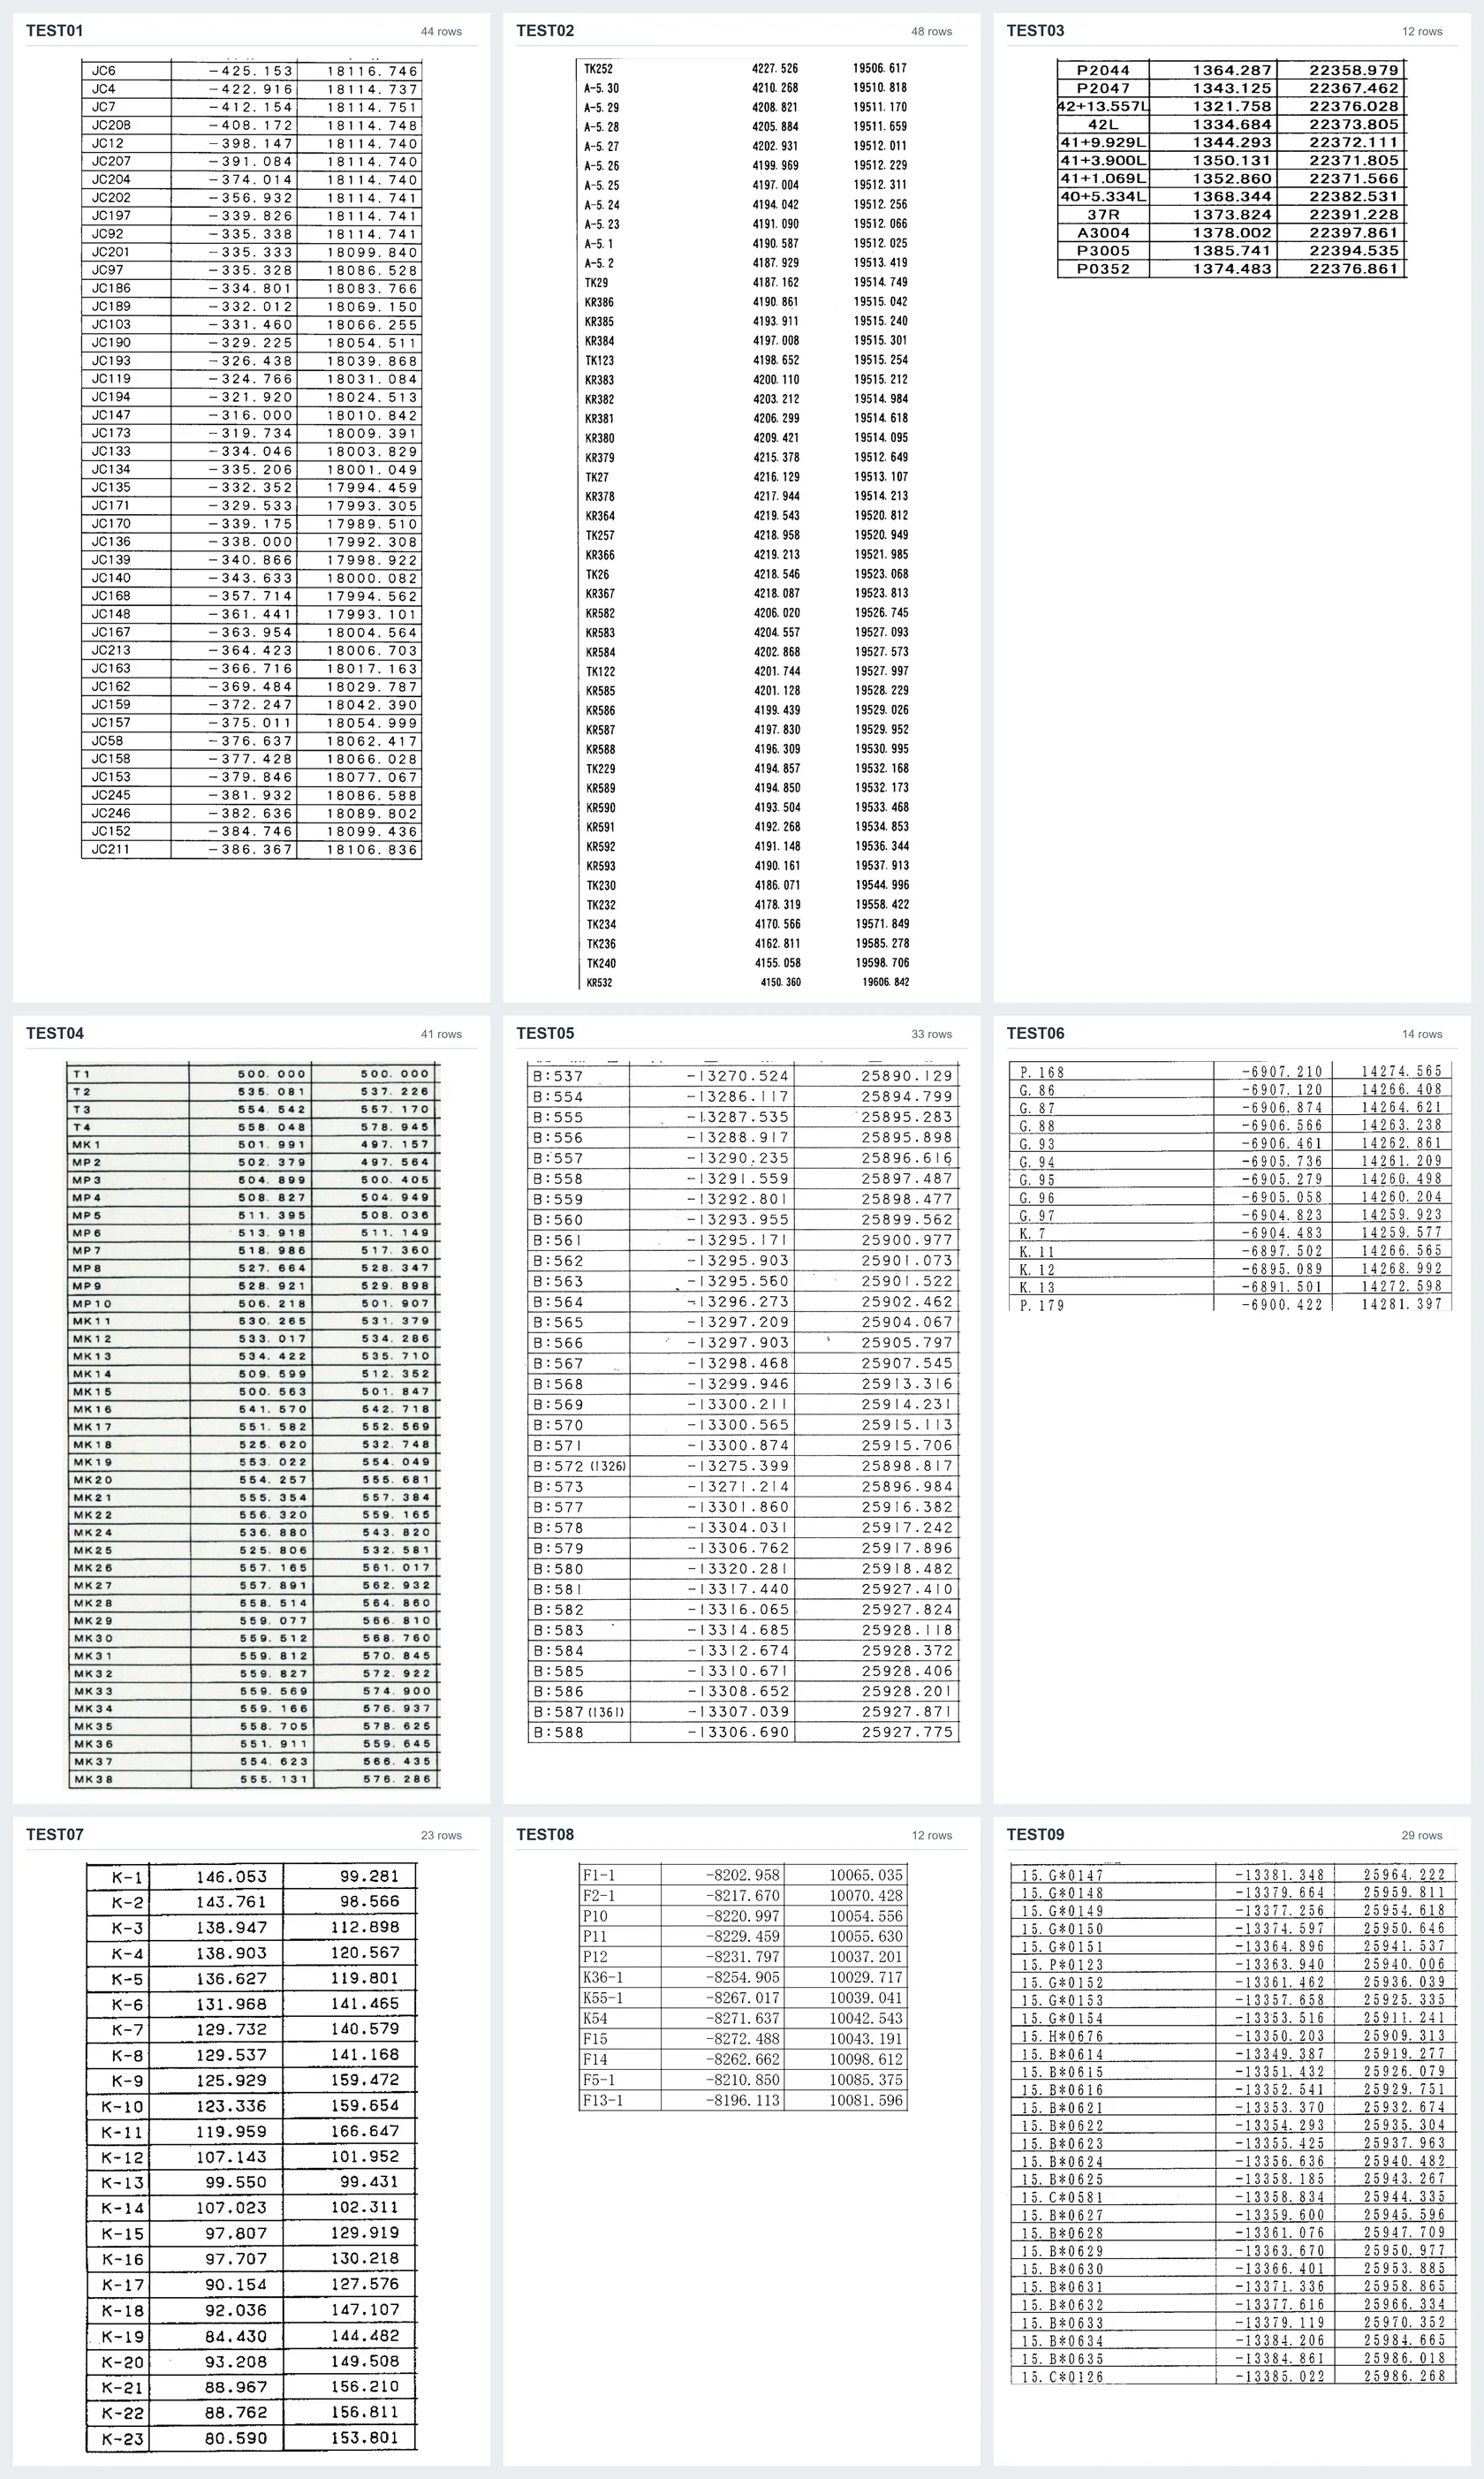
PDFの座標表を切り抜き、ローカルAIで読み取り、SIMAデータにするために作成したアプリを使い、同じ9枚・256行の座標表で、PC構成による処理時間の違いを比較しました。
Windows 11・llama.cpp・GLM-OCR Q8_0で各条件を3回測定し、OCR時間の中央値を掲載しています。モデル起動、PDFの切り抜き、確認・修正、SIMA出力は計測外です。RTX 5060 Tiのみ、以前のglm-ocr:bf16による測定を参考として加えました。
CPUでの処理結果
表は左右にスクロールできます。
| CPU | RAM・メモリ設定 | 理論メモリ帯域 | CPUスレッド数 | 9枚の処理時間 |
|---|---|---|---|---|
| Ryzen AI MAX+ 395 | 128GB・LPDDR5X-8000 | 256.0GB/s | 8 | 5分50秒 |
| Ryzen AI MAX+ 395 | 128GB・LPDDR5X-8000 | 256.0GB/s | 16 | 4分44秒 |
| Ryzen 7 7840HS | 32GB・DDR5-5600 | 89.6GB/s | 8 | 6分13秒 |
| Core i9-13900K | 64GB・DDR5・設定4000(16GB×4) | 64.0GB/s | 8 | 6分30秒 |
| Ryzen 7 5800U | 16GB・LPDDR4X-4266 | 約68.3GB/s | 8 | 18分28秒 |
| Core Ultra 7 258V | 32GB・LPDDR5X-8533 | 約136.5GB/s | 4 | 19分27秒※ |
メモリ設定はログとメーカー仕様を照合。帯域は実測値ではなく、395は256-bit、その他はデュアルチャンネル(合計128-bit)として計算しています。スレッド数はアプリの指定値です。
CPUスレッド数は、システムやほかの作業への影響を考え、各CPUの最大スレッド数の半分を基準に設定しました。初回の測定では上限を8スレッドとし、395は半分に相当する16スレッドでも測定しました。
※258Vは1回目の1画像で接続エラーが発生したため、正常完了した2回の参考値です。その2回も15分52秒と23分02秒に分かれています。
Ryzen 7 7840HSは、Zen 4世代の8コア16スレッドCPUです。今回のOCRは8スレッド設定で実行しました。
395、7840HS、13900Kは、8スレッドで9枚を約6分で処理できました。少量の座標表をときどき読み取るなら、CPUでも使える結果です。一方、5800Uや今回の設定での258Vは20分前後かかり、日常業務で繰り返し使うには厳しいと感じます。
395は同じメモリ構成のまま16スレッドに増やすと、所要時間が18.8%短縮しました。入力処理は約29.7%、文字生成は約7.7%の短縮です。スレッド数を倍にしても速度は倍になりませんでしたが、約1分の短縮は実用上の違いになります。
395の理論メモリ帯域は7840HSの約2.86倍ですが、8スレッドでのOCR速度差は約1.07倍でした。5800Uと13900Kも、理論帯域が近い一方で処理時間には約3倍の差があります。395では同じメモリのままスレッド数を増やすと入力処理が約30%短縮したことから、CPU側の入力処理もボトルネックの一つとなり、メモリ帯域の差がそのままOCR速度に表れていない可能性があると考えられます。ただし実効帯域は未測定で、CPUの演算だけが原因とは断定できません。
GPUでの処理結果
表は左右にスクロールできます。
| CPU | GPU・処理方式 | システムRAM | 9枚の処理時間 |
|---|---|---|---|
| Ryzen AI MAX+ 395 | Radeon 8060S・Vulkan | 128GB | 2分00秒 |
| Ryzen 7 7840HS | Radeon 780M・Vulkan | 32GB | 3分28秒 |
| Core i9-13900K | Intel UHD 770・Vulkan | 64GB | 9分22秒 |
| Core i9-13900K | RTX 4090 24GB・CUDA | 64GB | 23.13秒 |
| Ryzen 7 5800U | AMD Radeon Graphics・Vulkan | 16GB | 11分23秒 |
| Core Ultra 7 258V | Intel Arc 140V・Vulkan | 32GB | 3分39秒 |
| Ryzen 9 8945HX | RTX 5060 Ti 16GB〈過去測定〉 | 64GB | 51.48秒 |
RTX 5060 TiはUbuntu・Ollama・glm-ocr:bf16による1回の測定で、モデルロードとLAN経由の応答時間を含みます。画像は同じですが、今回のQ8_0・llama.cppとは条件が異なる参考値です。
Radeon 780MとArc 140Vは、どちらも約3分半でした。最近のノートPCで使われる内蔵GPUでも、少量の表を処理する用途なら使えそうです。ただし、UHD 770はCPUより遅く、GPUを使えば必ず速くなるわけではありません。
8060Sは約2分ですが、一般的な内蔵GPUとは性能差が大きいため、専用GPUとも比較しました。過去測定の5060 Tiは約51秒、今回の4090は約23秒です。今回の表では、5060 Tiでも1分以内に収まっています。
それにしても、CPUでは数分かかる9枚の座標表を、4090は約23秒で処理してしまいます。いつもながら、その圧倒的な性能にはビビります。
表は左右にスクロールできます。
| GPU | 理論メモリ帯域 | 9枚の処理時間 |
|---|---|---|
| Radeon 8060S | 256GB/s(CPUと共用) | 119.98秒 |
| RTX 5060 Ti | 448GB/s | 51.48秒〈過去測定〉 |
| RTX 4090 | 1,008GB/s | 23.13秒 |
4090と5060 Tiは、帯域比が2.25倍、OCR全体の速度差が約2.23倍と近い数字になりました。ただしモデルの精度や実行環境が異なるため、帯域だけの効果とは断定できません。
今回の結果から
今回の測定では、正常に取得できた323画像・延べ9,183行が正解CSVと一致しました。258VのCPU処理で1画像の接続エラーがありましたが、取得できた結果に座標の不一致はありませんでした。同じ9枚を繰り返した結果なので、実際の図面では出力確認が必要です。
軽量なGLM-OCR Q8_0でも、CPUである程度の速度を出すなら、AMDは今回の7840HSを参考に、Zen 4世代以降・8コア以上を一つの目安にしたいと思います。Intelは第12世代以降の上位モデルくらいが目安です。メモリはDDR5/LPDDR5系・RAM 32GBを目安にします。
内蔵GPUなら、Radeon 760M/Intel Arc 130Vクラス以上を実用速度の目安に考えます。今回、780Mと140Vは約3分半で処理できたため、仕様上その一段下の760Mや130Vも、少量の座標表なら実用候補になると見込んでいます。
これは測定結果と仕様から考えた目安で、動作の必須条件ではありません。第12世代Core、760M、130Vは今回未測定です。
比較的新しい高性能CPUなら、それなりの速度で動くことは確認できました。395では16スレッドで5分も切れています。それでも、軽量なGLM-OCRで数分待つことを考えると、CPUや一般的な内蔵GPUで大量の表を繰り返し処理するのは、まだ厳しいというのが実感です。
以前のglm-ocr:bf16の測定でも、5060 Tiなら約51秒でした。このくらいの待ち時間になると、仕事で繰り返し使う姿が見えてきます。
この軽量モデルでも快適に動かすのはなかなか大変なのに、重量級LLMを自分のPCで動かしている人たちの、機材へのお金のかけ方には驚かされます。座標表のOCRを試していたはずが、最後は「ローカルLLMガチ勢のお金のかけ方はすごいなぁ」という感想になりました。
※各PCはAC給電で測定しましたが、温度やバックグラウンド負荷までは統一していません。