土地家屋調査士業務では、地積測量図、道路境界確定図、 地籍調査成果などに記載された座標値を、 自身のCADへ入力しなければならない場面があります。
点数が少なければまだよいのですが、点数が多い資料では、 この入力作業は決して軽くありません。
BACKGROUND 座標表のOCRは、文字が読めればよいわけではない
この種の作業については、以前からOCRを試したことのある方も 多いと思います。
ただ、実務の感覚でいえば、座標表は単に文字が読めれば済む データではありません。 小数点や 0 / O の誤読は致命的ですし、 空白や列ずれが入るだけでも後段の処理に支障が出ます。
数行をそれらしく抽出できた、というだけでは実務では足りず、 結局は手入力の方が早くて正確、という結論になりがちです。
私自身、以前はPDFから座標部分を切り出し、 OCR(Docling)で読み取り、Excelに出力し、 そこからSIMA化する流れを作っていました。
考え方自体は単純ですが、実際にはこれだけでは安定しません。 スキャン画像は傾いていることも多く、切り出し位置も一定ではなく、 ソースの状態によって精度が大きくぶれます。
新しい地積測量図のように条件の良い資料ではそれなりに動いても、 道路境界確定図や紙資料をスキャンしたものでは、 実務で使えるほど安定しませんでした。
LOCAL LLM OCRの代わりにローカルLLMを使う
そこで発想を変え、OCRの代わりにローカルLLMを使う構成に 切り替えました。
現在の流れは次のとおりです。
- PDFから座標表部分を切り出す。
- 切り出した画像をLLMで読み取り、JSONで返させる。
- Python側でJSONを抽出し、正規化・検証・Excel出力を行う。
- 必要に応じて別モデルで比較する。
- 最終的にSIMA化する。
PROMPT & VALIDATION LLMには「推測させない」
ここで重要なのは、LLMに曖昧な指示を与えないことです。
実際には、左から1列目・2列目・3列目だけを読むこと、 1列目は文字列、2列目と3列目は数値、推測しないこと、 読めない行は出力しないこと、 説明文を付けずJSONのみを返すことまで制約しています。
返ってきた値はそのまま使わず、 Python側で数値正規化や形式チェックを行う構成です。
また、①の前処理も単なる手作業ではありません。 PDF上で表領域を複数選択でき、 保存時にはページごとの状態保持に加え、 必要に応じて傾き補正もかけます。
単にOCRをLLMに置き換えただけではなく、 前処理から含めて処理系として組んでいます。
MODELS qwen系モデルがかなり安定
モデルについてはいろいろ試しましたが、 現時点ではqwen系がかなり安定しています。
特にqwen3-vlやqwen3.5系は、 私の手元資料では実用域に入っていると感じています。 さらに大きいモデルは、速度との兼ね合いはあるものの、 比較用として使う価値があります。
人間の手入力でもダブルチェックが必要である以上、 LLM側でも別モデルによる照合を入れるのは自然です。
PROCESS 実際の処理工程
以下に、モザイク処理をしたうえで処理工程のキャプチャを掲載します。 これは某市の道路境界確定図です。
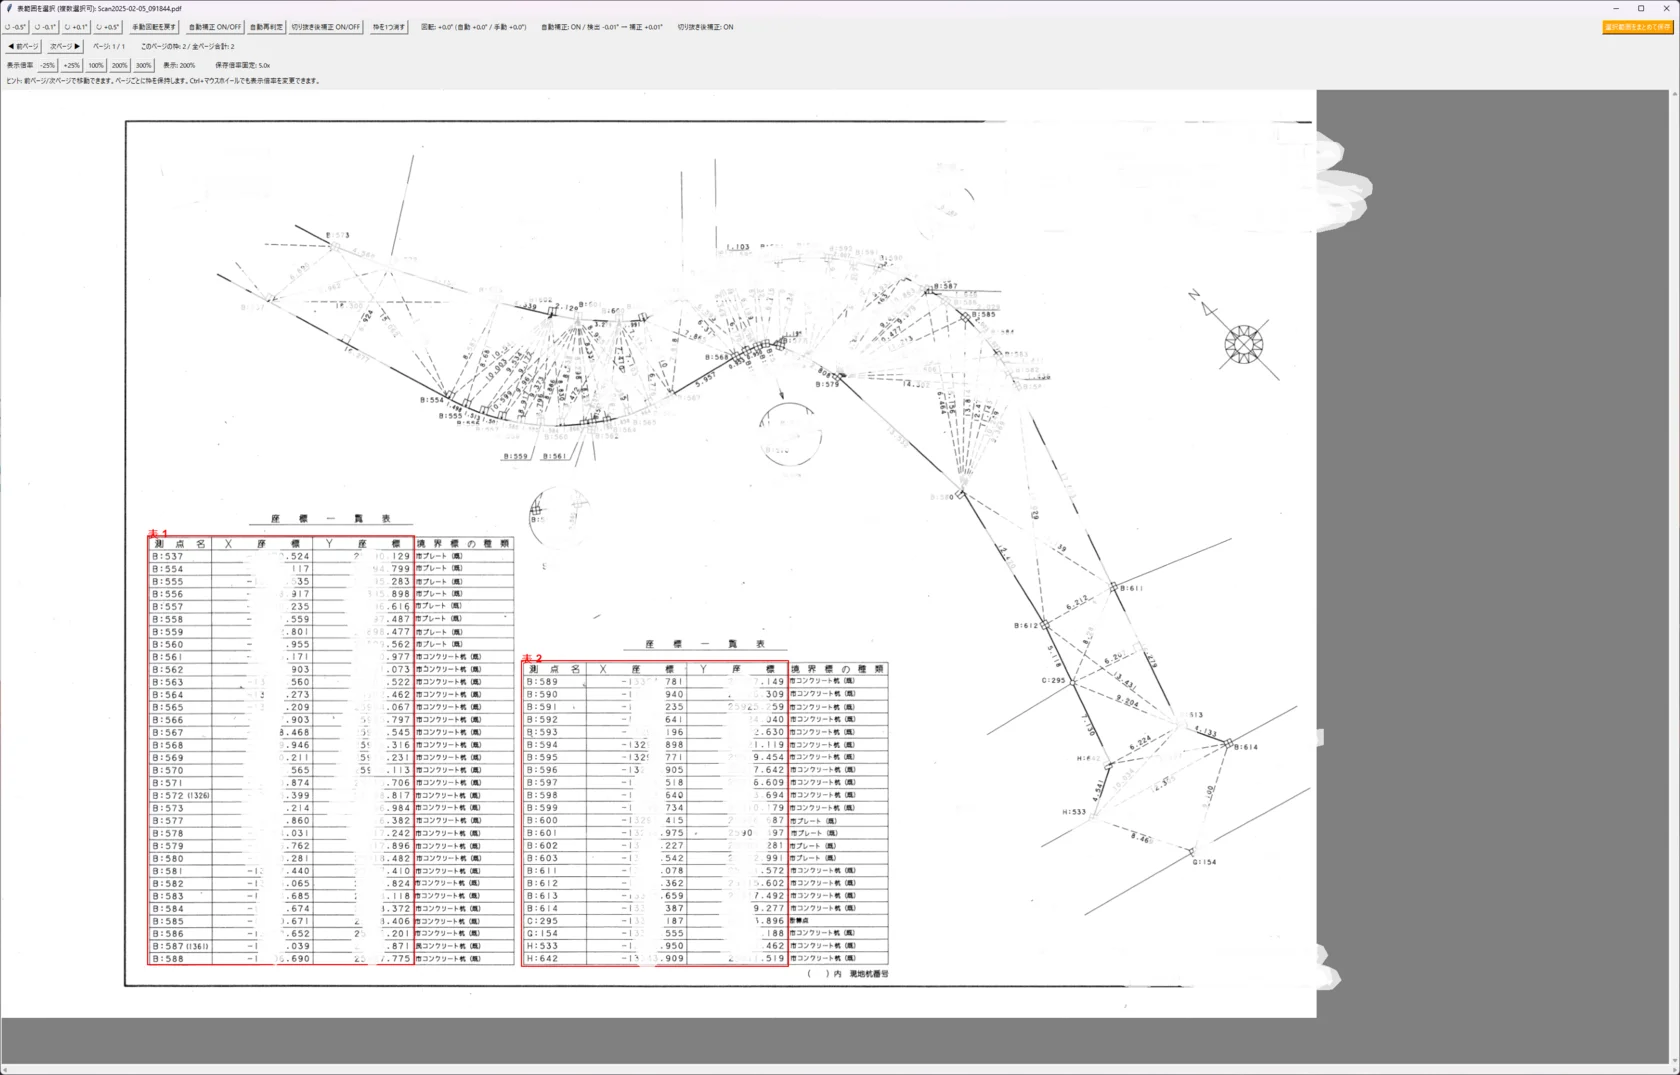
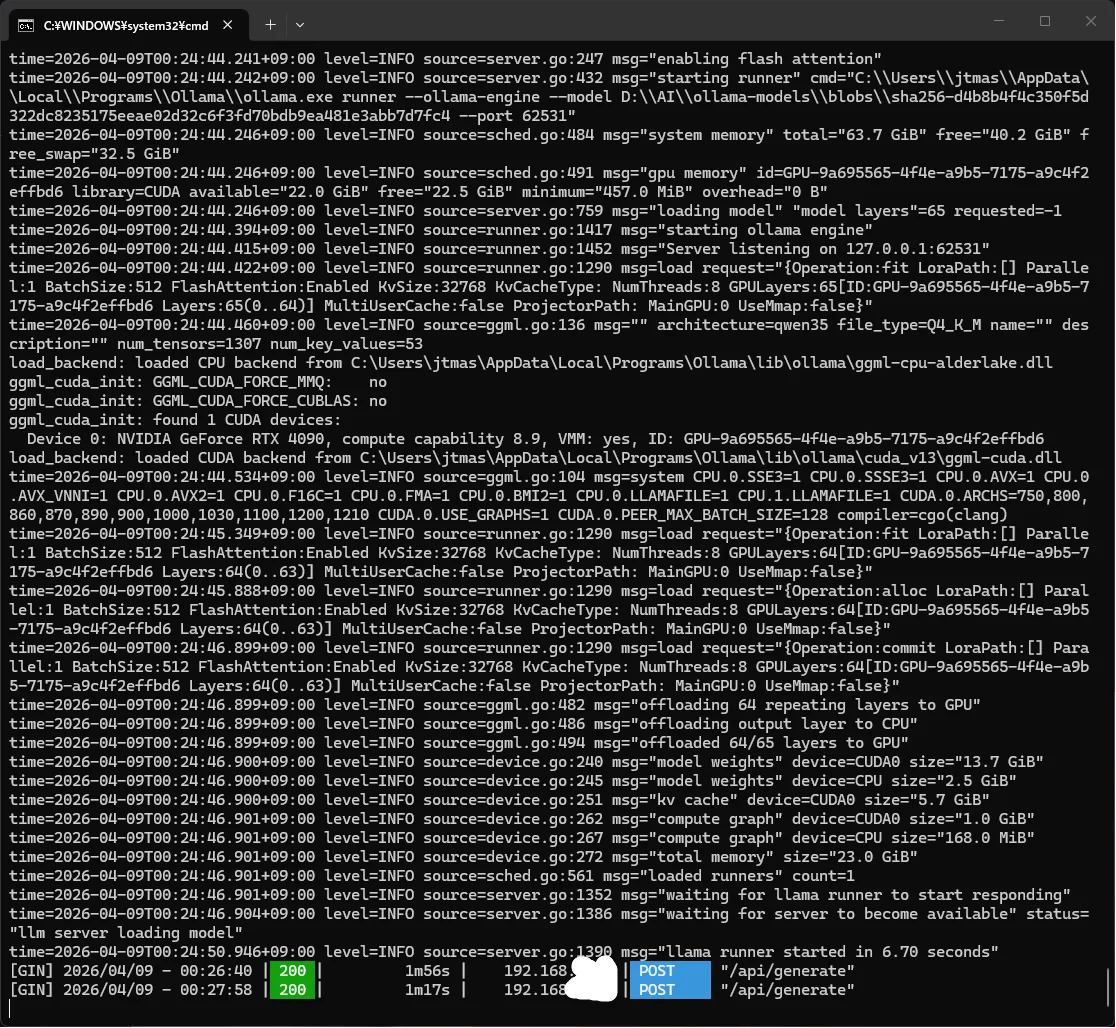
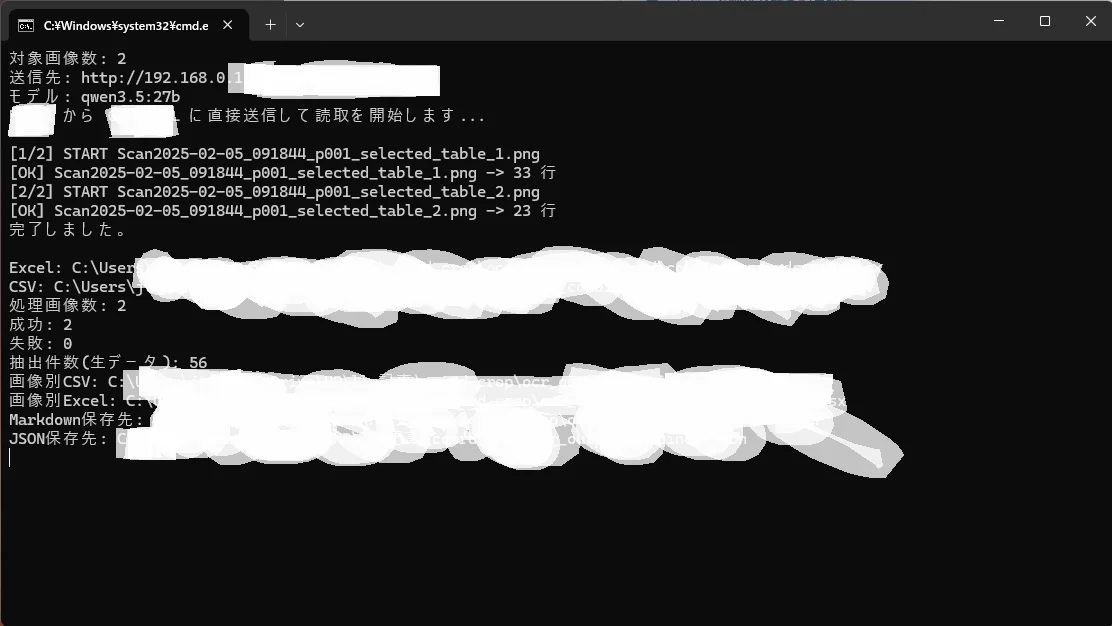
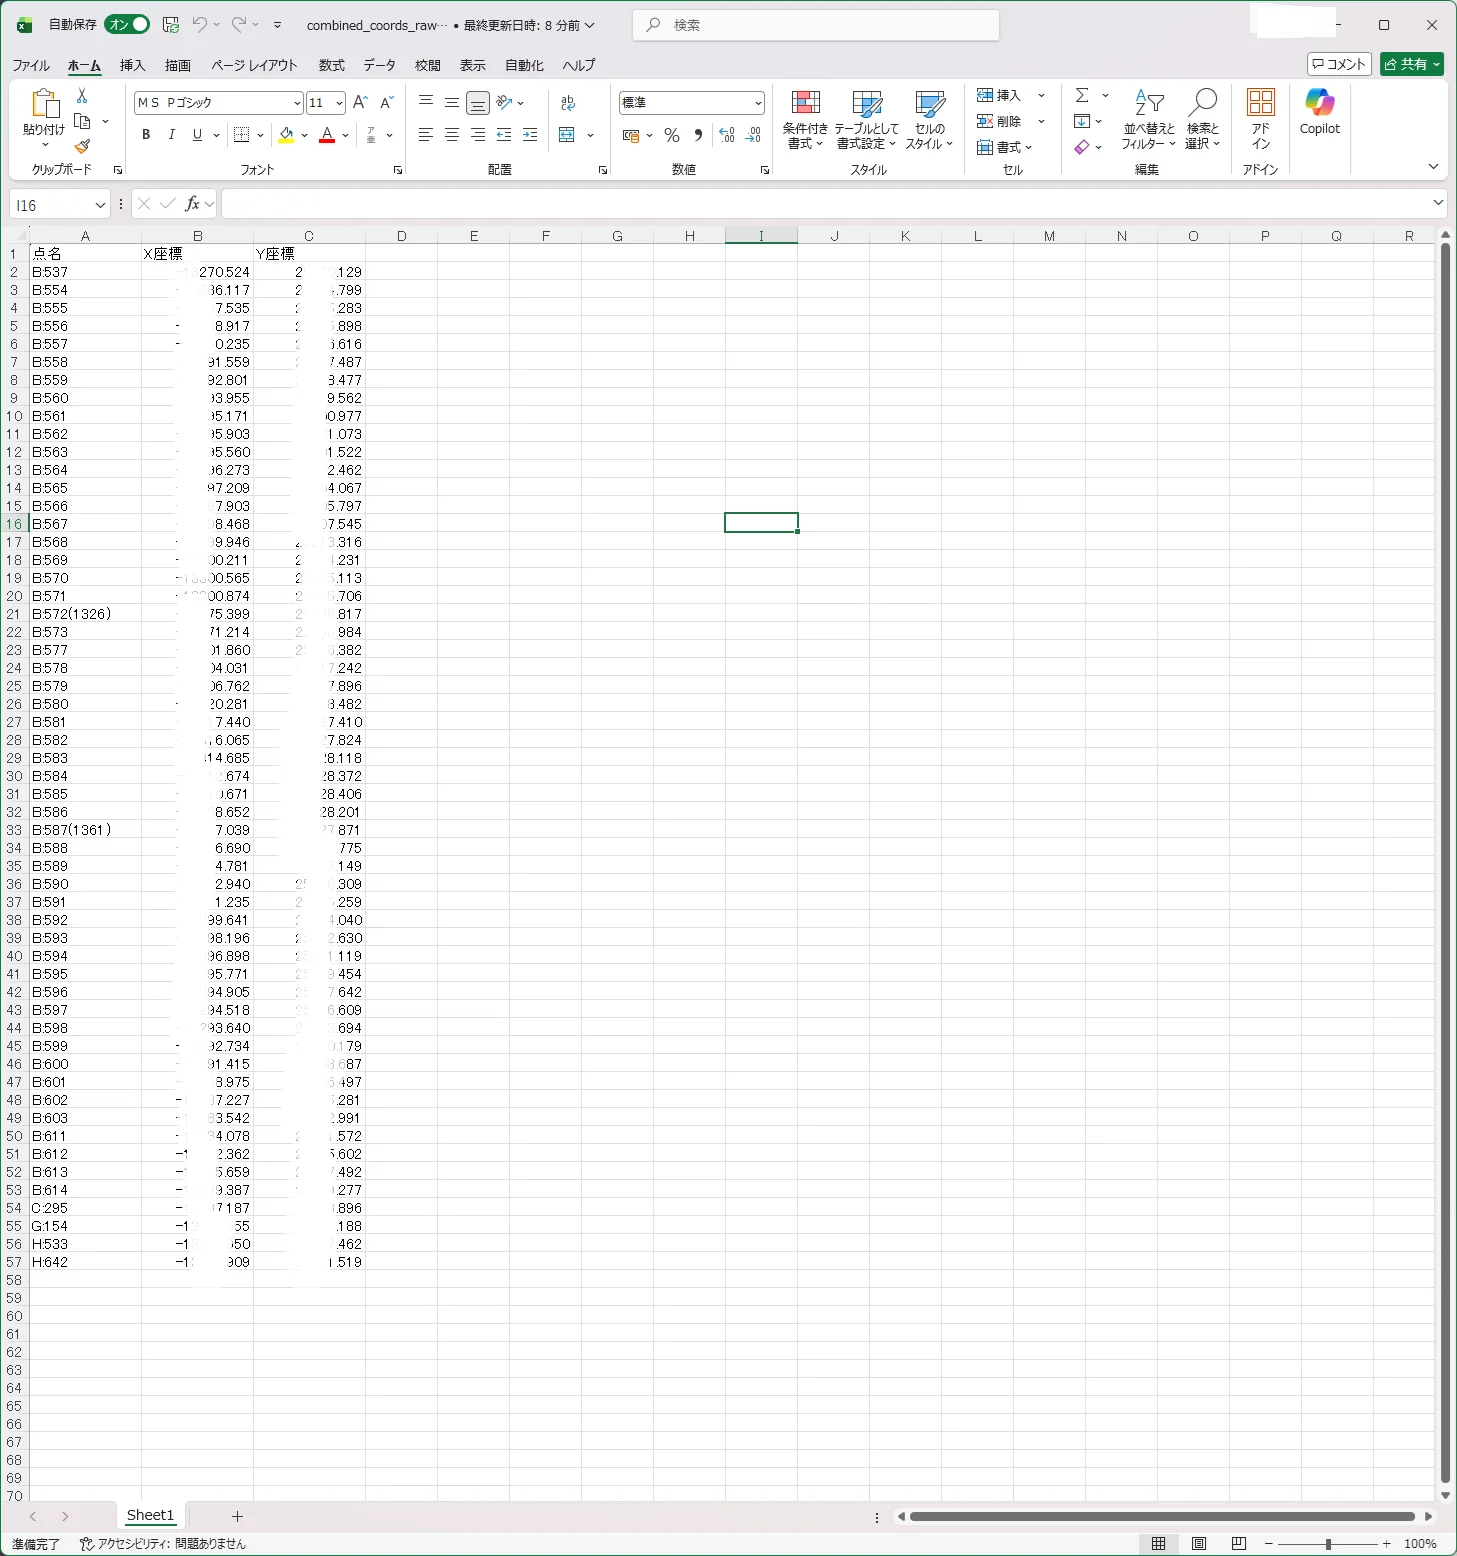
二つの座標部分のLLM処理に要した時間は、 1分56秒(33点)、 1分17秒(23点)でした。
今回のサンプルでは誤りは見当たりませんでした。 これであれば、手入力よりもかなり速いと感じます。
HARDWARE 今回は qwen3.5:27b × RTX 4090
今回はqwen3.5:27bをRTX 4090で処理しています。
今後さらにLLMの性能向上が見込まれることを考えると、 少しずつでも環境を整えていく価値はあると感じています。
Gemma4系モデルでもテストしましたが、 現時点では数値列末尾の安定性にやや問題があるように感じています。
プロンプトや前処理次第で改善の余地はあるかもしれません。 異なる系統のモデルで比較できれば、 ダブルチェックの信頼性はさらに高められそうです。