以前、PDFの座標表をローカルLLMで読み取り、SIMA化する処理について書きました。
地積測量図や道路境界確定図の座標を、普段使っているCADへ持っていきたい。目的はそれだけなのですが、点数が多くなると、手入力もなかなか大変です。
今回の256行を直接入力するとしたら、点名が256個、XとYの座標が合わせて512個。合計768項目を、図面と画面を行き来しながら打ち込むことになります。小数点やマイナス、似たような点名にも注意が必要です。しかも、打ち終わっただけでは終わりません。1桁違えば別の場所になってしまうので、元の表と照らし合わせる確認も必要です。
単純な転記ではありますが、256行となると、それなりに時間も集中力も使います。この部分を任せられるだけでも、実務ではかなり助かりそうです。
LLMで読み取れることは分かってきました。それなら次は、どのモデルを使うのがよいのか。
大きいモデルの方が正確なのか。軽いモデルでは難しいのか。そもそも、座標表を読むために高価なグラボが必要なのか。
ということで、同じ座標表をいくつかのモデルに読ませ、正確さと処理時間を比較してみました。結果からいうと、今回の資料では軽量モデルがかなり健闘しました。GLM-OCRについては、使い方を変えたことで結果が大きく変わっています。
TEST DATA今回使った座標表
用意したのは、実際の資料から切り出した座標表9枚、合計256行です。
| ID | 行数 |
|---|---|
| TEST01 | 44 |
| TEST02 | 48 |
| TEST03 | 12 |
| TEST04 | 41 |
| TEST05 | 33 |
| TEST06 | 14 |
| TEST07 | 23 |
| TEST08 | 12 |
| TEST09 | 29 |
点名は単純な英数字だけでなく、ハイフン、ピリオド、コロン、プラス、アスタリスク、括弧を含むものも入れました。きれいな表だけでなく、スキャンらしい線や文字の状態の違いも含めています。
点名に漢字などが使われる場合は、英数字中心の表より読み取りが難しくなることも想定されます。ただ、今回はテストに適した資料が手元になく、そのケースは確認できていません。今後、資料がそろえば試してみたいところです。
最も多いものが48行です。私の手元には50行を超える表がなかったので、今回はこれを長い表のサンプルにしました。
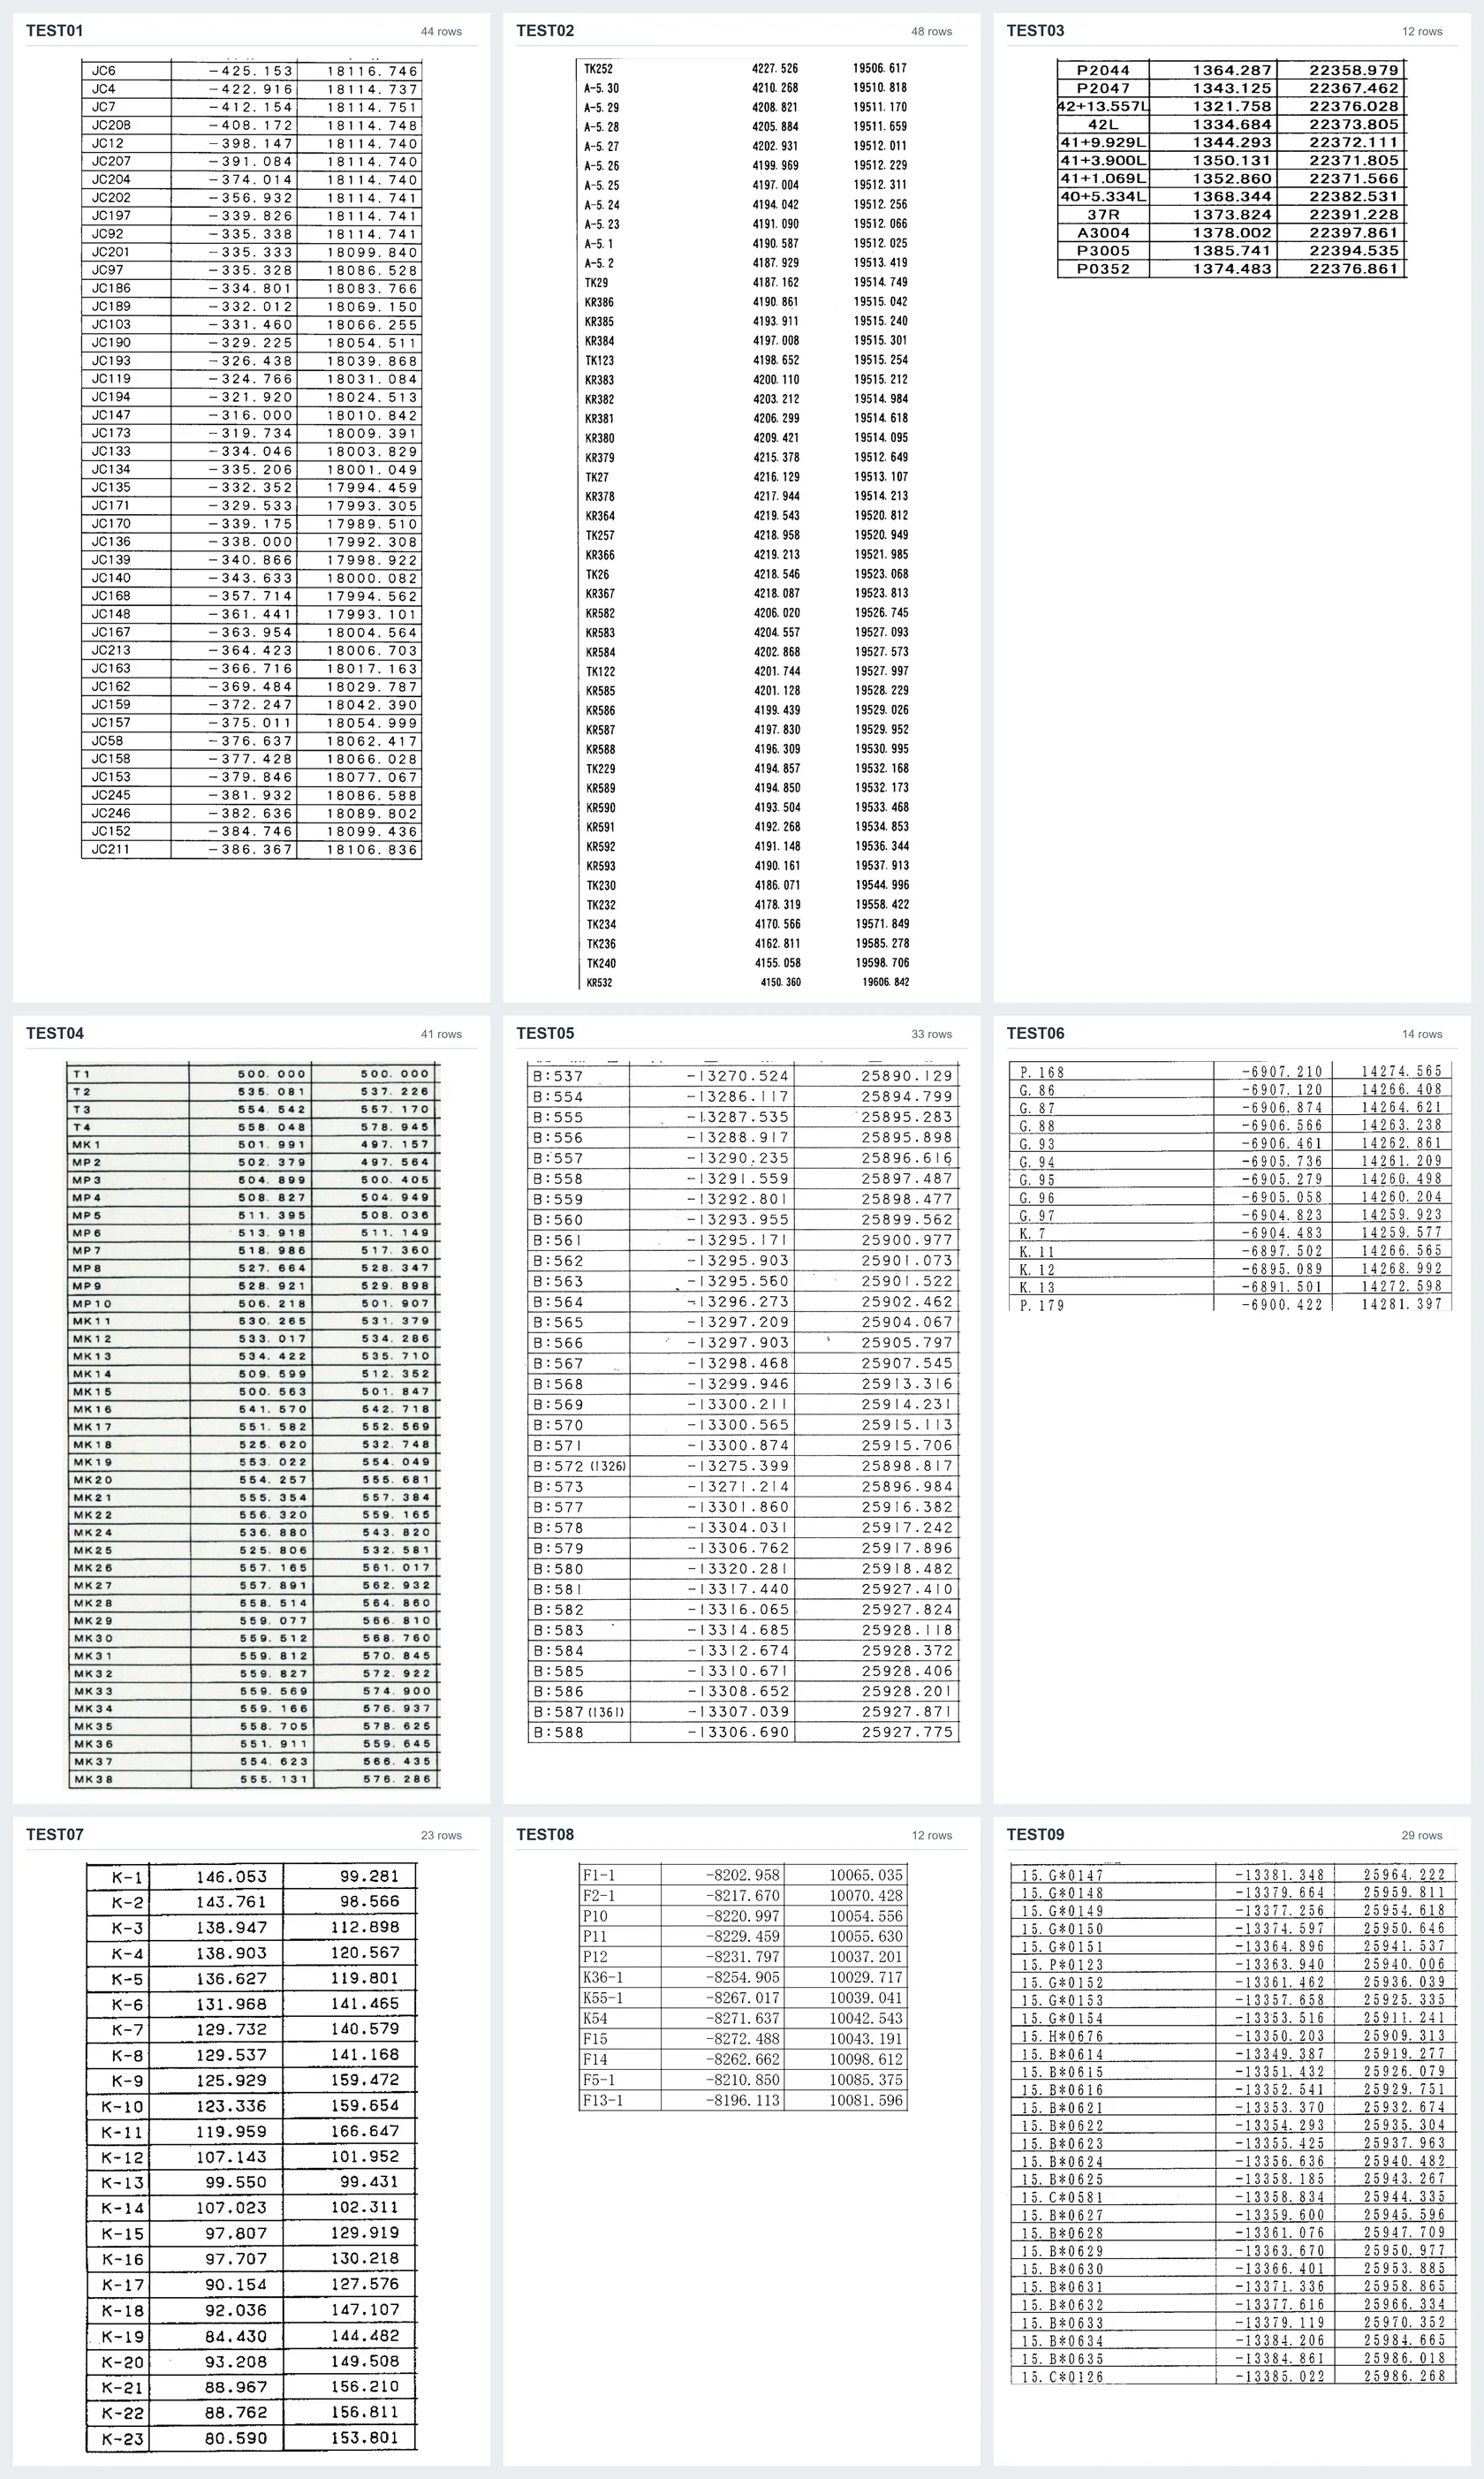
上の画像は掲載用に9枚を並べたものです。テストでは元の9枚をそれぞれ入力しており、表をさらに分割したり、モデルごとに画像を加工したりはしていません。
今回の正解座標はすべて小数3桁でした。ただし、処理を「小数3桁専用」にはしていません。座標は文字列として扱い、丸めたり、末尾にゼロを足したりせずに比較しています。
METHOD同じ画像を、それぞれに合った使い方で
実行環境は、Ubuntuサーバ、GeForce RTX 5060 Ti 16GB、Ollama 0.33.0です。PDFの操作やPythonの実行はWindows側で行い、LLMの推論だけをサーバへ依頼しています。
コンテキストサイズは、全モデルで8,192トークン(num_ctx=8192)に設定しました。これはモデルが対応する最大長ではなく、今回の比較で使用した設定値です。表に示した処理時間とVRAM割当量も、この設定で測定したものです。
最初は、全モデルへ同じ指示を出していました。「座標表を読んで、点名・X・Yを決められたJSON形式で返す」というものです。
これで素直に動いたのがQwen系でした。一方、GLM-OCRやDeepSeek-OCRは、そのままではうまくいきませんでした。
ただ、ここで「このモデルは読めない」と片付けるのも少し違います。私が知りたいのは、普段の作業で正確な座標を早く取り出せるかどうかです。
そこで、画像と正解データ、採点方法はそろえたまま、指示と回答の受け取り方をモデルに合わせて見直しました。QwenはJSON、GemmaはMarkdownの表、GLMはHTMLの表をPythonで読み取っています。DeepSeekにも専用の指示を試しました。
つまり、以下はモデルごとに調整した読取処理の比較です。同じプロンプトへの応答だけを比べたものではありません。設定を探すための予備試験を行い、方式を決めてから全9枚を処理しました。
INSTRUCTQwen3-VLをinstruct版にした理由
当初は qwen3-vl:4b と qwen3-vl:8b も試しています。ただ、今回の設定では、JSONが通常の回答欄に入らず、thinkingという別の欄に出てしまうケースがありました。
Ollamaの応答には、最終的な回答を入れる欄と、推論過程を入れる欄があります。こちらのプログラムは最終回答から座標を取り出すので、答えが別の欄にあると受け取れません。これは、画像を全く読めていないこととは別の問題です。
そこで、同じ4B・8Bクラスでも、指示に従って回答する用途の qwen3-vl:4b-instruct と qwen3-vl:8b-instruct で測り直しました。今回はこちらで通常の回答欄にJSONが返り、後段の処理へつなげられています。公式のタグ一覧でも、instruct版とthinking版は分かれています。
比較表にはinstruct版を載せ、instructの付かない4B・8Bの2つは外しました。失敗した点数を並べるより、実際に使える条件で比較した方が、今回の目的に合っていると思います。
GLM-OCR指示を変えると、結果も変わった
GLM-OCRは文書や表の読み取りを目的としたOCRモデルです。公式の使用例には、表を読むための専用の指示が載っています。
Table Recognition:これだけです。
共通のJSON指示を使っていた時は、各画像からほぼ1行ずつしか得られず、出力一致は8/256行でした。それが専用の指示に変えると、表全体がHTML形式で返ってきました。
ここまでは良かったのですが、今度は表を返しても、APIが処理完了を通知しない問題が残りました。そこで、表の終端で生成を終了する設定を加えています。
"stop": ["</table>"]この設定で、全9枚が正常終了し、点名の空白処理後は256/256行が一致しました。欠けた数字をPythonで補ったわけではありません。LLMが返した各セルの文字列を、そのまま取り出しています。
なお、この終了条件は1画像に1つの表がある今回の使い方に合わせたものです。複数の表が入っている画像では、最初の表で止まる可能性があります。
最初の結果だけ見ていたら、GLM-OCRは候補から外していたと思います。モデルの性能だけでなく、どう指示して、どう受け取るかも大事だった、ということですね。
RESULT11モデルの比較結果
出力一致は、点名・X・Yの3項目が正解と完全に一致した行数です。点名はExcelやSIMAへ出す時と同じように、文字幅をそろえ、内部の空白を除去してから比較しています。正解側にも同じ処理を行っています。
raw一致率は、その点名の空白除去を行う前の一致率です。JSONやHTMLから取り出した3項目の比較であり、回答文全体の一致率でも、座標だけの一致率でもありません。座標値には丸めや桁補完を行っていません。
比較表は左右にスクロールしてご覧いただけます。
| モデル | 出力一致 | raw一致率 | 平均時間 | トータル時間 | VRAM | オフロード |
|---|---|---|---|---|---|---|
glm-ocr:bf16 |
256/256(100.00%) | 99.22% | 5.72秒 | 51.48秒 | 2.14 GiB | なし |
qwen3-vl:4b-instruct |
256/256(100.00%) | 83.20% | 10.85秒 | 97.64秒 | 3.94 GiB | なし |
qwen3.5:4b |
256/256(100.00%) | 78.52% | 10.90秒 | 98.06秒 | 3.11 GiB | なし |
qwen3-vl:8b-instruct |
256/256(100.00%) | 94.53% | 16.50秒 | 148.52秒 | 6.09 GiB | なし |
qwen3.5:9b |
256/256(100.00%) | 78.52% | 17.01秒 | 153.13秒 | 5.34 GiB | なし |
qwen3.6:27b |
256/256(100.00%) | 83.20% | 45.63秒 | 410.69秒 | 12.53 GiB | 4.27 GiB |
qwen3.5:27b |
256/256(100.00%) | 67.19% | 124.44秒 | 1119.94秒 | 13.44 GiB | 2.78 GiB |
qwen3.8:27b |
256/256(100.00%) | 83.20% | 53.09秒 | 477.84秒 | 12.42 GiB | 4.54 GiB |
gemma4:e4b |
201/256(78.52%) | 67.58% | 8.78秒 | 79.06秒 | 3.14 GiB | なし |
gemma4:12b |
140/256(54.69%) | 48.05% | 18.29秒 | 164.64秒 | 7.80 GiB | なし |
deepseek-ocr:3b |
0/256(0.00%) | 0.00% | 6.54秒 | 58.83秒 | 7.31 GiB | なし |
平均時間は1枚あたり、トータル時間は9枚を1回ずつ処理した合計です。どちらも画像を送って応答を受け取るまでの実測を使い、モデルの読み込み時間と失敗した処理も含めています。Excel保存、再検算、SIMA作成の時間は含みません。トータルは丸める前の時間を合計しているため、表示した平均時間の9倍とわずかに違う場合があります。
VRAMはOllamaが報告したモデルのGPUメモリ割当量です。オフロードは、GPUに載せきれずCPU側へ割り当てられた量の推定値で、各実行の最大値を載せています。「なし」はこの推定値が0という意味で、CPUを全く使っていないという意味ではありません。
Qwen系は共通JSON方式、GLM・Gemma・DeepSeekはモデルごとに指示と回答の受け取り方を調整した結果です。後者は1モデルずつ読み込んで測定しています。冷間・温間の状態まで厳密にそろえた速度試験ではないので、秒数は今回の環境での目安として見てください。
MODELSそれぞれ使ってみた印象
glm-ocr:bf16
文書・表の読取に特化したモデルです。今回の専用指示では全256行が一致し、9枚で約51秒、VRAMは約2.14 GiBでした。raw一致率も99.22%で、残った違いは点名の空白の扱いです。今回の座標表読取では、かなり有力な候補になりました。
qwen3-vl:4b-instruct
画像と言葉を扱うQwen3-VLの軽量なinstruct版です。決められたJSON形式で返してもらいやすく、既存の処理へ組み込みやすいのが利点です。点名の空白を整えると全256行が一致し、1枚約11秒。速度と扱いやすさのバランスがよいと感じます。
qwen3.5:4b
こちらも画像入力に対応した軽量モデルです。同じ全行一致でも、VRAM割当は約3.11 GiBと、4B instructより少なめでした。処理時間もほぼ同じです。点名に空白が入りやすい傾向はありますが、今回の出力処理との組合せでは十分に使えそうです。Qwen3.5の公式説明
qwen3-vl:8b-instruct
4B instructより大きい画像対応モデルです。raw一致率は94.53%で、今回のQwen勢では最も高い値でした。点名を整える前から一致する行が多い一方、速度とVRAM使用量は4Bより増えます。今回、最終的な出力一致に差はありませんでした。
qwen3.5:9b
Qwen3.5の4Bと27Bの間に位置するサイズです。全行一致でしたが、今回の座標表では4Bを上回る精度差は出ず、時間とメモリ使用量が増えました。別の難しい資料では差が出るかもしれませんが、この9枚だけなら4Bでよさそうです。
qwen3.6:27b
全行一致で、今回の27B勢では最も速い結果でした。それでも9枚で約6分51秒かかり、CPU側へのオフロードもあります。軽量モデルと比べると、相応に重いです。
qwen3.5:27b
以前の座標読取でも使用していた大きなモデルです。今回も全行一致でしたが、9枚で約18分40秒と、この中では最も時間がかかりました。16GB GPUで一部をCPU側へ置く今回の実行条件では、軽量モデルほど手軽には回せません。オフロード量だけで、この時間差の原因を説明できるわけではありません。
qwen3.8:27b
全行一致、9枚で約7分58秒でした。読み取りはできていますが、今回の画像では小さいモデルに対する精度上の優位は見えませんでした。
gemma4:e4b
Googleの画像対応モデルで、省資源での実行を意識した系統です。E4BのEは有効パラメータ数に由来するため、Qwenの4Bと単純に同じ規模と考えるものではありません。Gemma 4の公式説明
今回、JSONから表形式への転記に変えると、一致行数は186行から201行へ増えました。ただ、長い表の誤読や行抜け、座標内部への空白挿入が残っています。速度は速いのですが、座標を任せるにはまだ気になるところがあります。
gemma4:12b
同じGemma 4の、より大きいモデルです。指示の調整後は128行から140行へ増えたものの、E4Bより良い結果にはなりませんでした。VRAM割当も約7.80 GiBあります。今回の用途では、大きくすればそのまま正確になるわけではありませんでした。
deepseek-ocr:3b
DeepSeek-OCRもOCR専用のモデルです。ただ、3Bという名前の割に、今回使ったF16版のVRAM割当は約7.31 GiBと大きめでした。モデル名の数字だけで必要なメモリを判断できない例でもあります。
専用の指示を4種類試しましたが、セルの区切りが失われた回答などが返り、安全に点名・X・Yへ戻せませんでした。表の0/256は「文字が何も読めなかった」という意味ではなく、採点できる座標行として取り出せなかった結果です。今回のOllama経由の処理では、採用できる形に持っていけませんでした。
HARDWARE8GBのグラボでも実用になりそう
今回、一番気になったのはここです。
正確に読めたモデルのVRAM割当は、GLM-OCRが約2.14 GiB、qwen3.5:4bが約3.11 GiB、qwen3-vl:4b-instructが約3.94 GiBでした。いずれもCPU側へのオフロードは確認されていません。
この数字を見ると、今回のような座標表読取であれば、8GBクラスのグラボでも実用レベルで動かせそうです。 1つのモデルを順番に実行する構成なら、16GBや24GBのGPUが必須とは限らないと思います。
もちろん、今回測定したのは16GB版のRTX 5060 Tiです。8GB機そのものでは試していませんし、速度はGPUの種類によって変わります。ほかのアプリが使うメモリや、画像・コンテキストの大きさでも必要量は変わります。あくまで今回の実測から見た見通しです。
それでも、座標表を読むためにまず大きなモデルと高価なGPUを用意する、という考え方は、少し見直してもよさそうです。
NEXT次は、読取とダブルチェックの組合せ
軽量Qwenのうち、4B instruct、qwen3.5:4b、8B instructは、別途9枚を3回ずつ処理する試験も行いました。3モデルとも、点名の空白処理後は768/768行が一致しています。GLMについては、今回の条件で全9枚を1回確認した段階です。
私としては、まずGLM-OCRと軽量Qwenを候補にして、一次読取と別モデルによる照合を組み合わせたいと考えています。同じ資料を違う系統で読む意味はありそうですが、モデルが違えば必ず間違いを見つけられる、とまでは言えません。
今回の比較はOCR読取だけです。画像との再照合や、SIMAにしてCADへ取り込んだ後の確認まで評価したものではありません。また、設定調整に使った画像も含む9枚なので、これだけであらゆる測量図面に対応できるという話でもありません。
最終的には、元画像と読み取り履歴を残し、SIMA化してCADで確認するところまで、できるだけ手間なくつなげたいところです。
WORK手入力の時間を、お茶を飲む時間へ
表に載せたのは、あくまでLLMが画像を読み取る時間です。実際の作業では、その前にPDFから座標表を切り出し、読み取ったデータをSIMAへ変換する工程が入ります。
ただ、LLMによるOCR処理に、PDF上で表の範囲を指定する作業と、データからSIMAを生成する処理を加えても、256行を一つずつ手入力するのに比べれば、短い時間で済みそうです。図面の枚数や表の配置にもよりますが、一連の作業全体で見ても、業務時間の短縮に大いに役立ちそうです。
今回は全工程を通して計測したわけではないので、「何分の作業が何分になった」とまでは言えません。それでも、768項目を入力する負担が減り、SIMAをCADへ取り込んで確認するところへ早く進める意味は大きいと思います。
確認が済んだら、少しゆっくりお茶でも飲みたいですね。
CLOUDグラボを買う、その前に
ここまでローカルLLMとグラボの話をしてきましたが、座標表を読み取ることが目的なら、ChatGPTでおなじみのOpenAIのモデルをAPI経由で使う方法もあります。今回のようなPythonの処理から呼び出す場合は、OpenAI APIを利用する形です。
例えば、画像入力に対応したGPT-5.4 miniの標準API料金は、入力100万トークンあたり0.75ドル、出力100万トークンあたり4.50ドルです。仮に、画像分も含めた課金対象の入力が合計2万トークン、推論分を含む課金対象の出力が1万トークンなら、計算上は合計0.06ドルです。これは費用感を示すための仮定で、今回の9枚をクラウドで測った結果ではありません。OpenAI公式のモデル・料金情報
実際の料金はモデルや画像の扱い、再照合の回数などで変わりますし、今回の資料をどれだけ正確に読めるかも別途確認が必要です。それでも、たまに座標表を処理する程度なら、APIの利用料はそれほど大きな負担にならない可能性があります。資料を外部へ送れる業務であれば、グラボを新しく買う前に試してみる価値はありそうです。
まぁ、グラボを買ってローカルで動かすのも楽しいのですが、結局、クラウドでもどうにかなってしまいそうですね。近い将来、PDFのどこに座標表があるかを見つけるところから、読み取り、SIMA化まで、自動でできそうな予感もします。こちらが表の範囲を指定する出番も、そのうちなくなるのかもしれません。